Grundlagen
Beherrschen Sie die Kernkomponenten von elluminate und wie sie zusammenarbeiten, um eine systematische Bewertung von KI-Systemen zu ermöglichen
Dieser Abschnitt zeigt, wie elluminate aufgebaut ist: drei Evaluationstypen mit jeweils eigenen Testdaten, die auf gemeinsamen Bausteinen aufsetzen. Wenn Sie das in Aktion sehen möchten, schauen Sie sich unseren Schnellstart an oder erkunden Sie unsere detaillierten Konzeptleitfäden unten.
Projekte und Evaluationstypen
Projects dienen als übergeordneter Container für Ihre gesamte Bewertungsarbeit. Projekte können innerhalb Ihrer Organisation privat (nur Projektmitglieder haben Zugriff) oder öffentlich sein.
Innerhalb eines Projekts wählt der Evaluation-Umschalter in der Seitenleiste einen von drei Evaluationstypen und bestimmt, welche Seiten die Seitenleiste zeigt (siehe Navigation). Jeder Typ hat eigene Testdaten und erzeugt die bewerteten Antworten auf eigene Weise:
| Evaluationstyp | Was bewertet wird | Testfälle | Antworten stammen aus | Leitfaden |
|---|---|---|---|---|
| Single-turn | Eine Antwort pro Testfall | Single-turn-Collection | Einem Prompt-Template, das mit einer LLM-Config ausgeführt wird, oder importierten Antworten | Prompt-Templates, Collections |
| Persona | Gespräche zwischen simulierten Personas und Ihrem Bot, bewertet als Transkripte | Szenario-Set | Personas einer Persona Group im Gespräch mit Ihrem Bot | Personas |
| Agent | Vollständige Trajektorien eines Agenten, den Sie selbst ausführen | Agent-Collection | Traces, die Sie hochladen oder aus Langfuse importieren | Agent-Evaluationen |
Gemeinsame Bausteine
Die folgenden Konzepte funktionieren für jeden Evaluationstyp gleich.
Criterion Sets und Criteria
- Criterion Sets gruppieren verwandte Bewertungsfragen und liegen in der Kriterien-Bibliothek
- Criteria sind spezifische binäre Fragen, die Antwortqualität bewerten
- Jedes Kriterium erhält eine "Ja"- oder "Nein"-Bewertung mit detaillierter Begründung
Experimente
Ein Experiment ist ein Evaluationslauf eines bestimmten Typs. Es verbindet die Testfälle und die Antwortquelle des Typs mit einem Criterion Set und bewertet jede Antwort danach. Siehe Experimente.
LLM-Configs
LLM-Configs (die Seite Modelle) legen Anbieter und Parameter eines Modells fest. Single-turn-Experimente erzeugen damit Antworten, Persona-Experimente nutzen sie für den getesteten Bot. Agent-Experimente brauchen keine, da elluminate Ihren Agenten nicht ausführt.
Response Analyse
Sobald Antworten generiert und bewertet wurden, bietet Response Analyse Tools, um:
- Einzelne Antwortbewertungen zu überprüfen
- Muster über mehrere Antworten zu identifizieren
- Performance über verschiedene Konfigurationen zu vergleichen
- Datengetriebene Verbesserungen an Ihrem AI-System vorzunehmen
Versionskontrolle
Versionierung gewährleistet Bewertungskonsistenz und ermöglicht Änderungsverfolgung:
- Komponenten wie Templates, Collections, Criterion Sets und Personas sind versioniert
- Experimente referenzieren spezifische Versionen für Reproduzierbarkeit
- Änderungen erstellen neue Versionen, während historische Daten erhalten bleiben
Single-turn: Templates und Collections
Die Single-turn-Evaluation baut auf PromptTemplates, TemplateVariables und den daraus resultierenden Prompts auf.
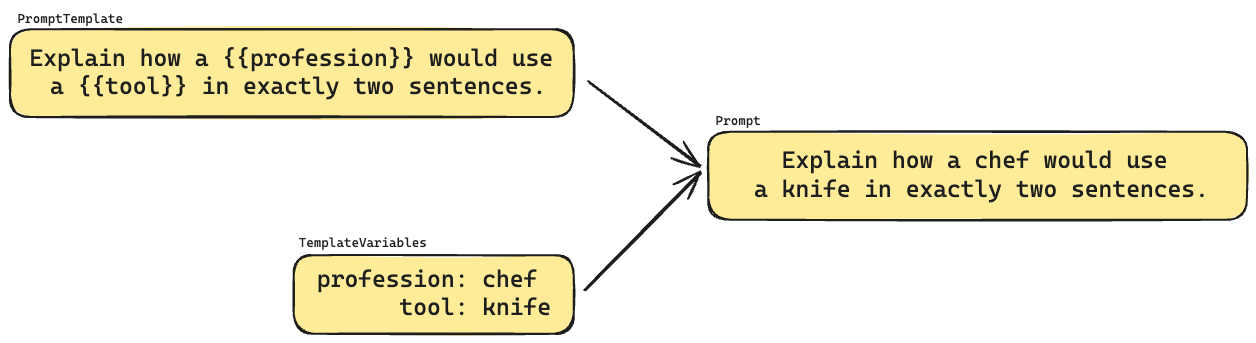
- Prompt templates sind wiederverwendbare Vorlagen mit Variablen, die durch spezifische Werte ersetzt werden können
- Template variables sind Key-Value-Paare, die in einem Prompt-Template eingefügt werden können
- Prompts sind das Ergebnis der Kombination eines Prompt-Templates mit Template-Variablen
Template-Variablen werden in einer Collection (speziell einer TemplateVariablesCollection) gruppiert, sodass ein Template für jeden Testfall einen Prompt erzeugt.
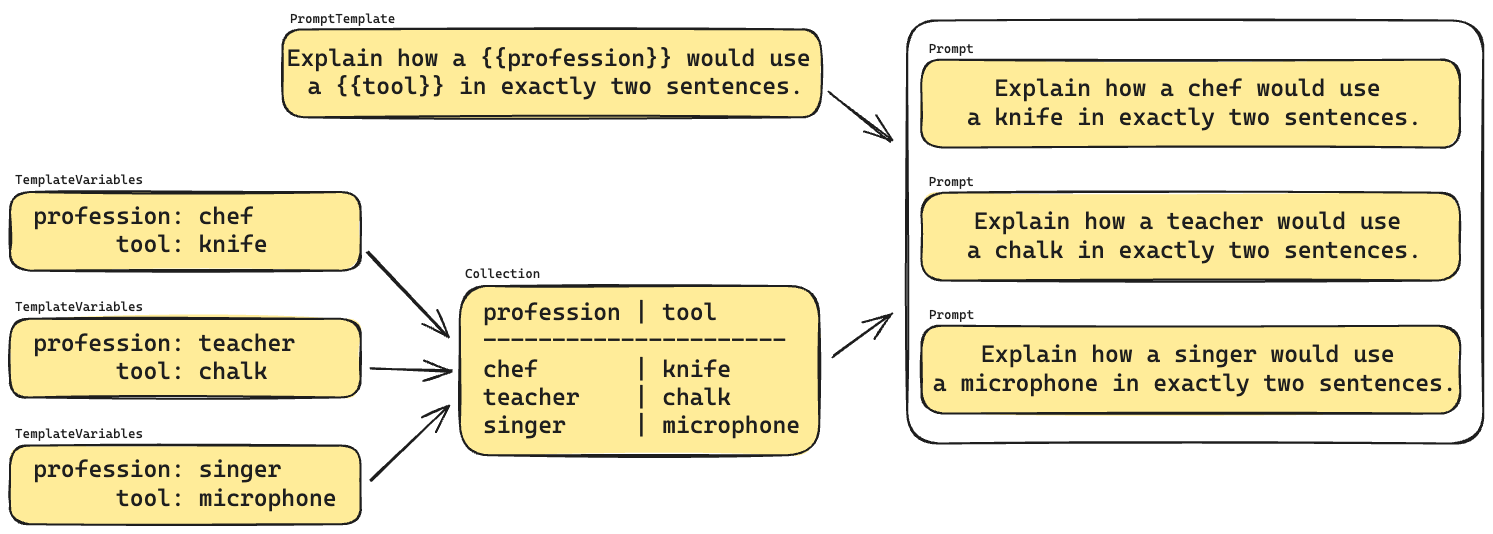
Die Leitfäden unter Single-turn-Evaluation behandeln Templates, Collections und Techniken wie Conversations, strukturierte Ausgaben und Tool Calling.
Nächste Schritte
Jetzt, da Sie die grundlegenden Konzepte verstehen, können Sie:
- Die gemeinsamen Konzepte im Detail mit den Leitfäden in diesem Abschnitt erkunden
- Die Leitfäden zu Ihrem Evaluationstyp öffnen: Single-turn-Evaluation, Persona-Evaluation oder Agent-Evaluation
- Unserem Schnellstart folgen, um diese Konzepte in Aktion zu sehen
- Die SDK-Beispiele für programmatischen Zugriff ausprobieren